本記事はAIを使用して整理した業務ニュースです。重要事項はリンク先の原典をご確認ください。
長期タスク向けAIエージェント基盤「Argus」、検証を挟む持続型実行を提案
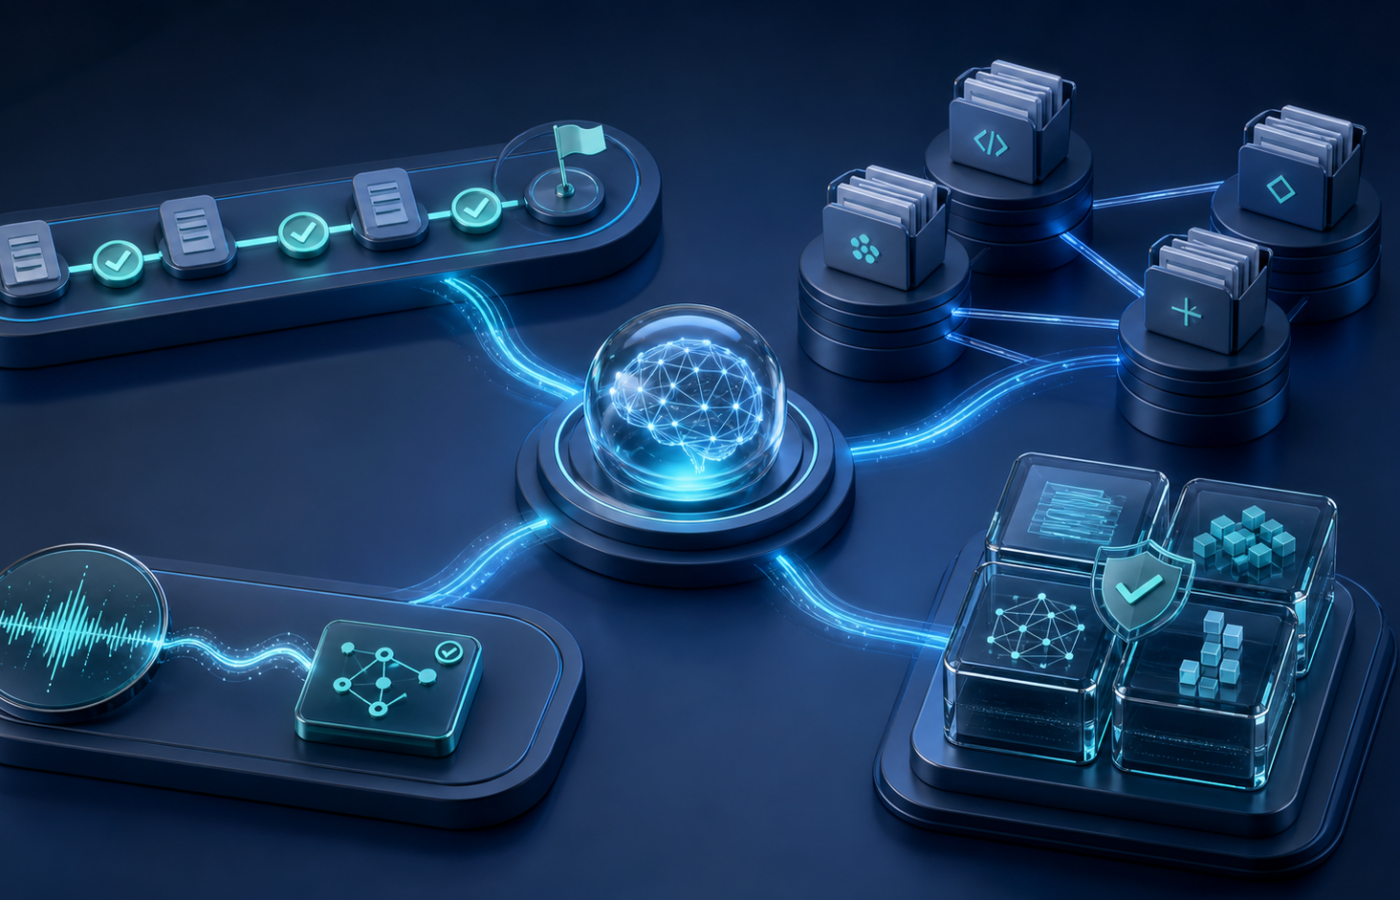
2026年8月6日未明(日本時間)に公開された論文は、Manager、Planner、Engineer、Reviewerが永続的なプロジェクト状態を共有し、検証結果に応じて継続または方針転換する実行基盤Argusを提案しました。著者らの評価では、固定したモデル重みのまま、検証を通過した記憶や手順を蓄積し、SWE-Bench Proなど複数の評価環境で直接実行型の比較対象を上回ったと報告しています。結果は論文内の評価条件に基づくもので、一般的な本番環境で同じ性能を保証するものではありません。
ポイント・活用法
企業がAIエージェントを長時間動かす際は、モデル性能だけでなく、目的・制約・検証基準を永続状態として分離し、人が判断すべきエスカレーション地点を先に定義する設計が重要です。ソフトウェア保守や調査業務では、失敗ルートも記録し、検証済み成果だけを再利用する運用が監査性と再現性の向上につながります。
複数リポジトリの依存関係を学ぶ「OctoLong」、長文コード理解を強化
同日に公開されたOctoLongは、ASTパーサー、言語サーバー、パッケージマネージャーを用いて参照関係を再帰的にたどり、複数リポジトリにまたがる長大なコード文脈を構築する手法です。論文では、従来の長文脈学習コーパスの12%をOctoLongデータに置き換えた条件で、長距離検索、状態追跡、リポジトリ単位のコード理解、エージェントタスクの改善を報告しています。
ポイント・活用法
大規模な社内システムでは、単一リポジトリだけを与えるより、API、共有ライブラリ、依存パッケージまで参照関係を保ったコンテキスト設計が有効である可能性があります。導入時は、機密コードのアクセス境界、依存関係の鮮度、生成結果のテストをセットにし、単純なコンテキスト長の拡大だけで品質が上がると見なさないことが重要です。
音声を構造化された操作へ変換する「Spoken Function Calling」
Spoken Function Calling(SFC)は、音声理解を閉じた分類問題ではなく、明示的な規則を持つ関数呼び出しとして扱う研究です。著者らは音声関数群とSFC-Benchを構築し、大規模言語モデルと音声言語モデルを評価したうえで、事後学習により意味抽出精度が向上したと報告しました。
ポイント・活用法
現場点検、移動中の入力、ハンズフリー操作では、音声を自由文のまま保存するだけでなく、承認、検索、登録などの定義済み操作へ変換する設計が有望です。ただし、誤認識が実行につながるため、金額・宛先・削除など高リスク操作には復唱確認、権限制御、操作ログを必須にするべきです。
推論学習データは量だけでなく正しさと難易度設計が鍵
Reasoning Coreは、数学、論理、計画、状態追跡、コードなど50種類の生成器から検証可能な推論課題を作るデータ群です。論文は、3Bモデルを含む比較で複数ベンチマークの平均スコア改善を報告する一方、意味的に正しい生成データでも学習に有用とは限らず、短く明確な正解形式と調整された難易度が重要だと指摘しています。生成、表示、正解、採点の不一致を、人とモデルによるレビューおよび回帰テストで監査しました。
ポイント・活用法
社内向けAIを業務データで評価・調整する場合、サンプル数よりも、正解定義、採点ロジック、難易度分布、回帰テストの整合性を優先すべきです。特に計画やコード生成では、合成データを自動生成した後に人の判定と機械的な検証を組み合わせ、誤った教師データが広がるのを防ぐ必要があります。
今日のまとめ
本日の研究からは、企業の生成AI活用が単発の回答生成から、長期タスクの状態管理、複数システムをまたぐ文脈設計、音声による業務操作、学習・評価データの監査へ広がっていることが分かります。注目点はモデルの大きさだけではなく、検証、権限、ログ、失敗からの復旧を実行基盤に組み込めるかです。導入判断では各論文のベンチマーク結果を出発点とし、自社データと実運用条件で再評価してください。